Obxectivo
Desenvolver un método computacional que permita:
Segmentar as estradas existentes nunha imaxe de entrada. É dicir, dada unha imaxe aérea, proporcionar unha máscara binaria cos píxeles de estrada a 1 e o resto a 0.
Para un conxunto de imaxes de proba, proporcionar un conxunto de métricas de avaliación cuantitativa da segmentación apropiadas para a aplicación obxectivo, usando o ground truth correspondente.
Esquema do traballo
Cargar as imaxes de entrada e cada ground truth.
Experimentación de posibles operacións sobre as imaxes orixinais que nos permitan obter características relevantes dos puntos.
- Probáronse diferentes filtros e técnicas de procesamento de imaxe para atopar aquelas que mellor se adapten á segmentación de estradas.
Creación dun vector de características por cada píxel da imaxe aérea.
- Os valores obtidos coas operacións do paso anterior caracterizarán a cada píxel da imaxe.
División no conxunto de adestramento e de test.
- Divídese o 80% das imaxes para o adestramento e o 20% restante para a avaliación do modelo.
Creación e adestramento dun clasificador cos vectores de características e etiquetas obtidas.
- Defínese a arquitectura do clasificador, proban diferentes modelos.
Avaliación do clasificador co conxunto de imaxes de proba e obtense a segmentación de estradas.
Obtéñense as métricas de avaliación do clasificador co conxunto de test.
Predícense as etiquetas de cada píxel da imaxe de entrada e obtense a segmentación de estradas.
Visualízase a segmentación obtida e compárase co ground truth correspondente.
As mellores predicións son sometidas a un post-procesado
1. Cargar a imaxe e o ground truth
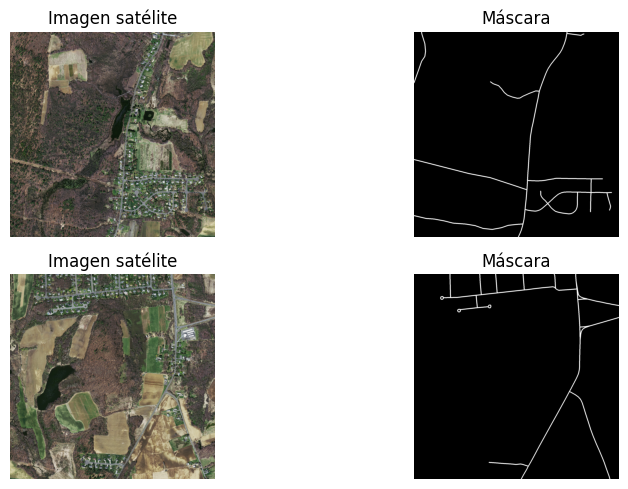
Imaxe aérea de entrada e o seu ground truth
2. Experimentación para a extracción de características
Experimentouse con diferentes filtros e técnicas de procesamento de imaxes para obter características relevantes que nos axuden a segmentar as estradas.
3. Vector de características
Tras a experimentación con diferentes filtros e técnicas de procesamento de imaxes, decidiuse que o vector de características estará formado polos seguintes elementos:
Canles R, G e B da imaxe orixinal para obter información de cor.
Canles H e S da imaxe en espazo HSV para obter información de cor.
Umbralización manual sobre a canle b (previamente expandida)
Umbralización de Otsu sobre as canles H e S
Dirección e magnitude do gradiente da imaxe en escala de grises.
def caracteristicas(imagen):
    """
    Calcula as características dunha imaxe de satélite para a detección de estradas.

    Args:
        imagen (ndarray): Imaxe de entrada.

    Returns:
        array: Características da imaxe.
        - Canles R, G e B da imaxe orixinal para obter información de cor.
        - Umbralización manual sobre a canle b (previamente expandida)
        - Umbralización de Otsu sobre a canle H e S
        - Dirección e magnitude do gradiente da imaxe orixinal cun sigma de 1 e discretización a 36 direccións.
    """

    ## Convertimos a imaxe a escala de grises
    imagen_gray = skimage.color.rgb2gray(imagen)

    ## Calculamos o gradiente e a orientación cun sigma de 1 e discretización a 36 direccións
    grad = magnitud_gradiente(imagen_gray, sigma=1)
    orient = orientacion_gradiente(imagen_gray, sigma=1, angulos_discretos=8)

    ## Convertimos a imaxe a HSV
    imagen_hsv = skimage.color.rgb2hsv(imagen)

    ## Obtemos as canles H e S
    canal_h = imagen_hsv[:, :, 0]
    canal_s = imagen_hsv[:, :, 1]

    ## Calculamos o gradiente e a orientación da canle H
    # grad_h = magnitud_gradiente(canal_h, sigma=1)
    # orient_h = orientacion_gradiente(canal_h, sigma=1, angulos_discretos=8)

    ## Umbralizamos as canles H e S usando Otsu
    umbral_h = skimage.filters.threshold_otsu(canal_h)
    umbral_s = skimage.filters.threshold_otsu(canal_s)

    ## Convertimos a imaxe a LAB
    imagen_lab = skimage.color.rgb2lab(imagen)
    # Obtemos a canle b
    canal_b = imagen_lab[:, :, 2]
    # Normalizamos a canle b ao rango [0, 1]
    canal_b = (canal_b + 128) / (127 + 128)
    # Expandimos o histograma da canle b
    canal_b = exposure.rescale_intensity(canal_b, in_range='image', out_range=(0, 1))
    # Umbralizamos a canle b usando un umbral manual
    umbral_b = 0.4

    ## Creamos unha lista coas características
    caracteristicas = [imagen[:, :, i] for i in range(3)] + \
                      [canal_h] + \
                      [canal_s] + \
                      [canal_b < umbral_b] + \
                      [canal_h > umbral_h] + \
                      [canal_s > umbral_s] + \
                      [grad, orient]

    ## Reshape das características para que teñan a mesma forma
    caracteristicas = np.array(caracteristicas)
    caracteristicas = np.transpose(caracteristicas, (1, 2, 0))

    return caracteristicas
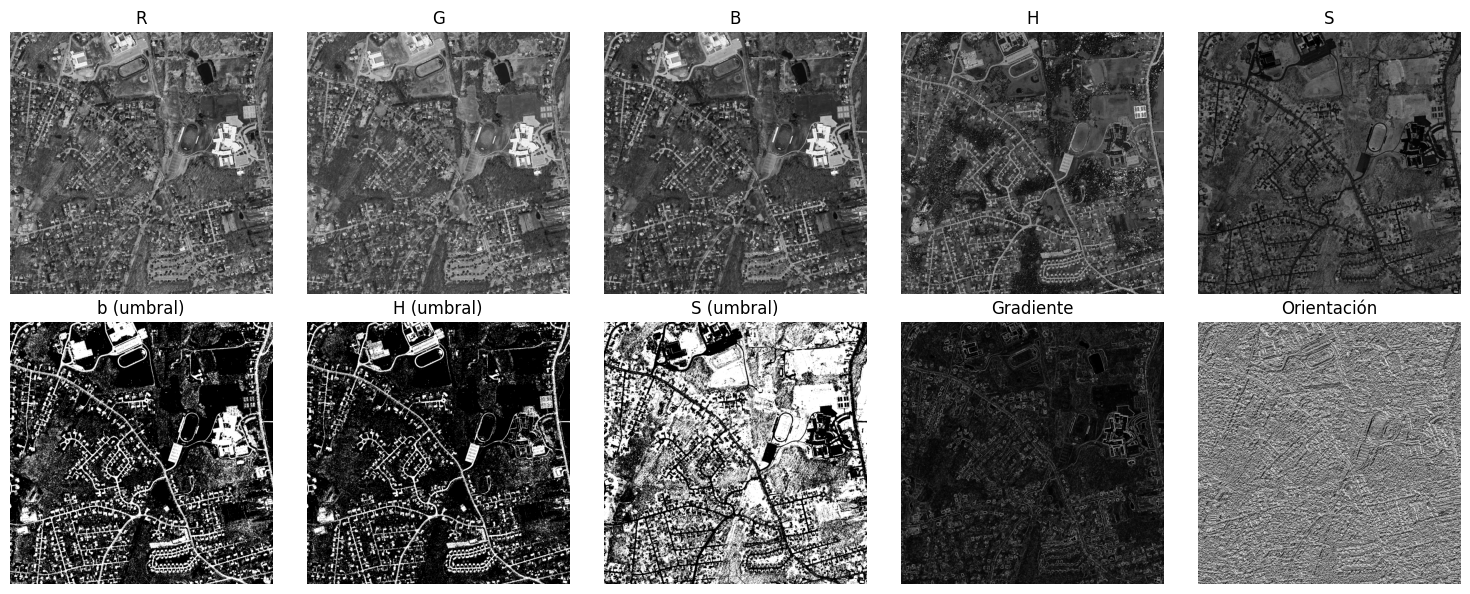
Exemplo do vector de características construído polo clasificador
4. Creación dos conxuntos de adestramento e test
Dividimos as imaxes de satélite nun conxunto de adestramento (80%) e un conxunto de test (20%). Prescindimos do uso de funcións para a división dos conxuntos de adestramento e test, xa que o tamaño das imaxes é pequeno pero dispar e non é necesario realizar unha división aleatoria.
Realmente, se o obxectivo soamente é segmentar as estradas nas imaxes concretas, a división de datos non sería necesaria, sería suficiente con adestrar un modelo con todas as imaxes sen importar que este sobreadestre, é máis, sería incluso útil un sobreadestramento.
No traballo decidimos dividir os datos para tratar de adestrar un modelo que poida xeneralizar a outras imaxes de estradas, non soamente ás imaxes concretas que se nos ofrecen.
5. Creación do clasificador
A función seguinte servirá para crear o noso clasificador binario (estrada / non estrada) facendo uso dunha rede convolucional.
def modelo1(input_shape):
    inputs = layers.Input(shape=input_shape)

    x = layers.Conv2D(32, (3, 3), activation='relu', padding='same')(inputs)

    x = layers.Conv2D(16, (3, 3), activation='relu', padding='same')(x)

    x = layers.Conv2D(1, (1, 1), activation='sigmoid', padding='same')(x)

    outputs = layers.Reshape((input_shape[0], input_shape[1]))(x)
    model = models.Model(inputs=inputs, outputs=outputs)

    model.compile(optimizer=optimizers.Adam(learning_rate=0.001),
              loss=losses.BinaryCrossentropy(),
              metrics=[
                  metrics.BinaryAccuracy(name='accuracy'),
                  metrics.Precision(name='precision'),
                  metrics.Recall(name='recall'),
                  metrics.AUC(name='auc')])

    return model
Aclaración:
A nosa métrica fundamental para avaliar o rendemento será AUC (Area Under Curve). O noso problema é un claro exemplo dun problema de clasificación binaria no que as clases están altamente desbalanceadas, a gran maioría dos píxeles non son estrada.
Por este motivo, a accuracy non é unha métrica adecuada xa que pode ser enganosa. Por exemplo, se o clasificador predí que todos os píxeles son fondo, a accuracy será igualmente alta (acertou na maioría dos píxeles) pero non aprendeu nada.
Sen embargo a métrica AUC é aquela que nos indica o ratio entre falsos positivos e verdadeiros positivos, polo que é unha métrica máis adecuada para o noso problema. Será 1 se a clasificación é perfecta e 0.5 se a clasificación é aleatoria.
Nota:
Hai que ter en conta que o uso da métrica non evita o problema de desbalanceo, simplemente axudaranos a avaliar o rendemento do clasificador.
En caso de querer mitigar o problema de desbalanceo, poderíanse aplicar técnicas como o oversampling, o uso de pesos dándolle máis importancia á clase minoritaria (estrada) ou a definición de funcións de perda específicas para este problema.
Neste caso, aínda que se probou a modificar a función de perda nalgún dos modelos creados (presente na parte final do Notebook), chegamos a un adestramento satisfactorio sen esta técnica. De todas formas, debemos ser conscientes do problema existente.
Creamos o clasificador e adestrámolo co conxunto de adestramento. Este modelo recibe como entrada directamente a matriz de 1500x1500x10, non se realiza un flatten da imaxe. Cada unha das imaxes constitúe un batch.
## Creamos o modelo
INPUT_SHAPE = (1500, 1500, 10)
model = modelo1(input_shape=INPUT_SHAPE)

## Resumen do modelo
model.summary()

## Adestramos o modelo
history = model.fit(x_train, y_train, epochs=5, batch_size=1)

## Gardamos o modelo
model.save("modelo1.keras")
Conclusión
Creamos unha rede convolucional con dúas capas de 32 e 16 neuronas respectivamente e activación relu e outra capa de 1 neurona e activación sigmoid. Probouse a definir unha arquitectura máis complexa pero o aumento da complexidade non ofrecía melloras significativas e aumentaba considerablemente o custo computacional, resultando practicamente imposible o adestramento. Utilizouse a función de perda
binary_crossentropye o optimizador Adam. O adestramento realizouse durante 5 épocas. A métrica utilizada para avaliar o rendemento do clasificador é AUC (Area Under Curve).A saída da rede é un valor entre 0 e 1 que indica a probabilidade de que o píxel sexa estrada, máis adiante tratarase con isto para obter a segmentación binaria.
6. Avaliación do clasificador no conxunto de imaxes de proba
Cargamos o clasificador model.keras e avaliámolo co conxunto de test. Obtemos as métricas de avaliación.
Conclusión:
Obtemos un AUC de 0.89, o que indica que o clasificador ten un bo rendemento. Avaliarase de forma cualitativa a segmentación obtida nas imaxes de proba.
Definimos unha función para visualizar os resultados. Mostrarase a imaxe de satélite, o ground truth e a segmentación obtida polo clasificador. Cabe destacar que a saída do noso modelo, e polo tanto da predición é unha probabilidade entre 0 e 1 para cada píxel, polo que se aplicará un umbral para converter a saída a unha imaxe binaria.
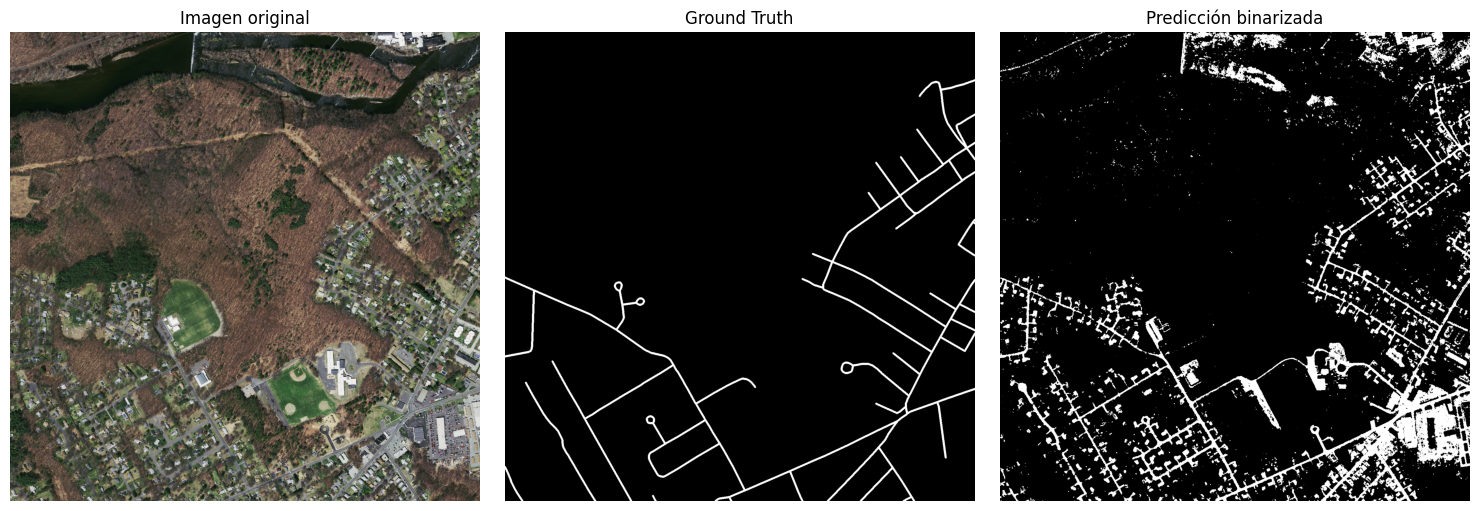
Comparativa da segmentación en imaxe de proba (1)
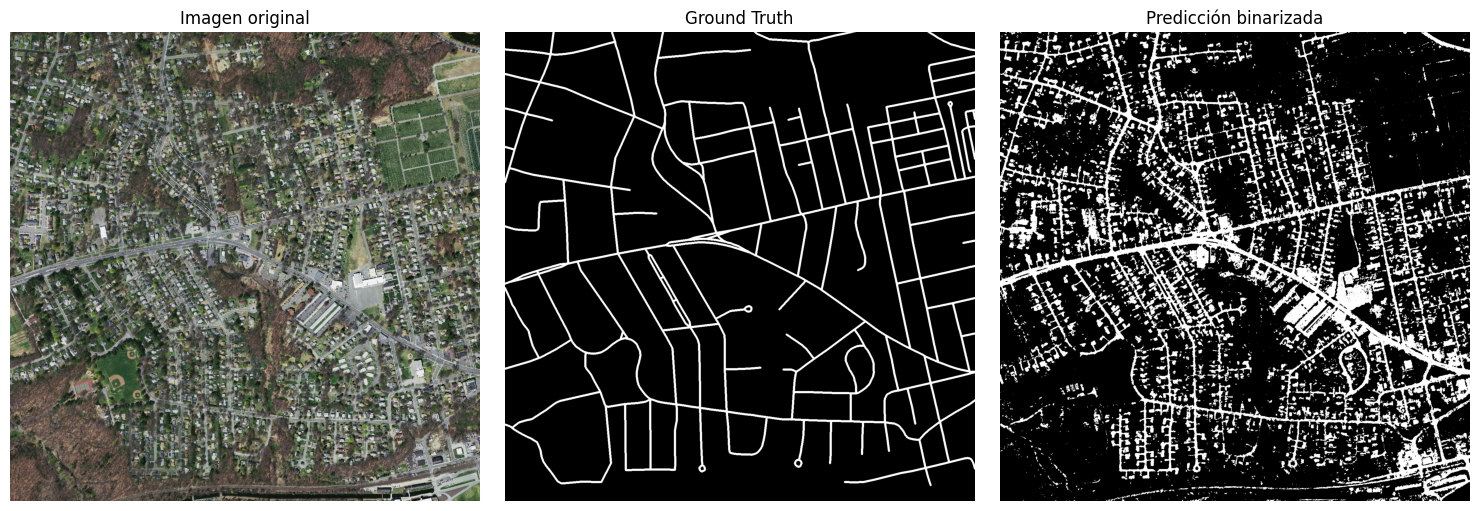
Comparativa da segmentación en imaxe de proba (2)
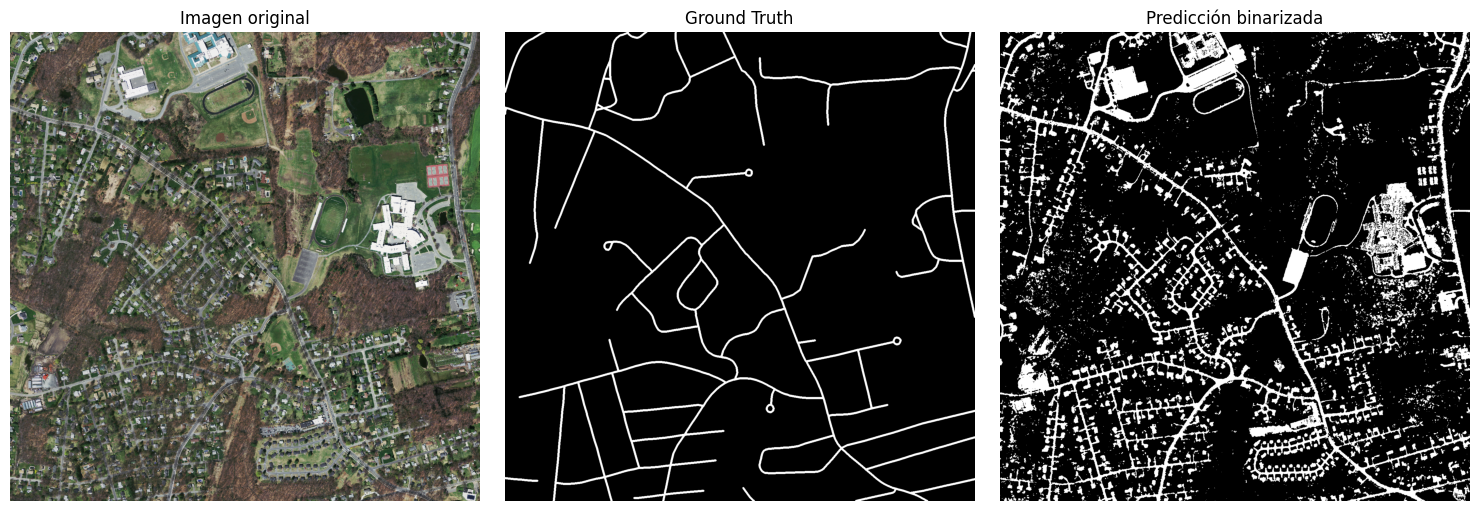
Comparativa da segmentación en imaxe de proba (3)
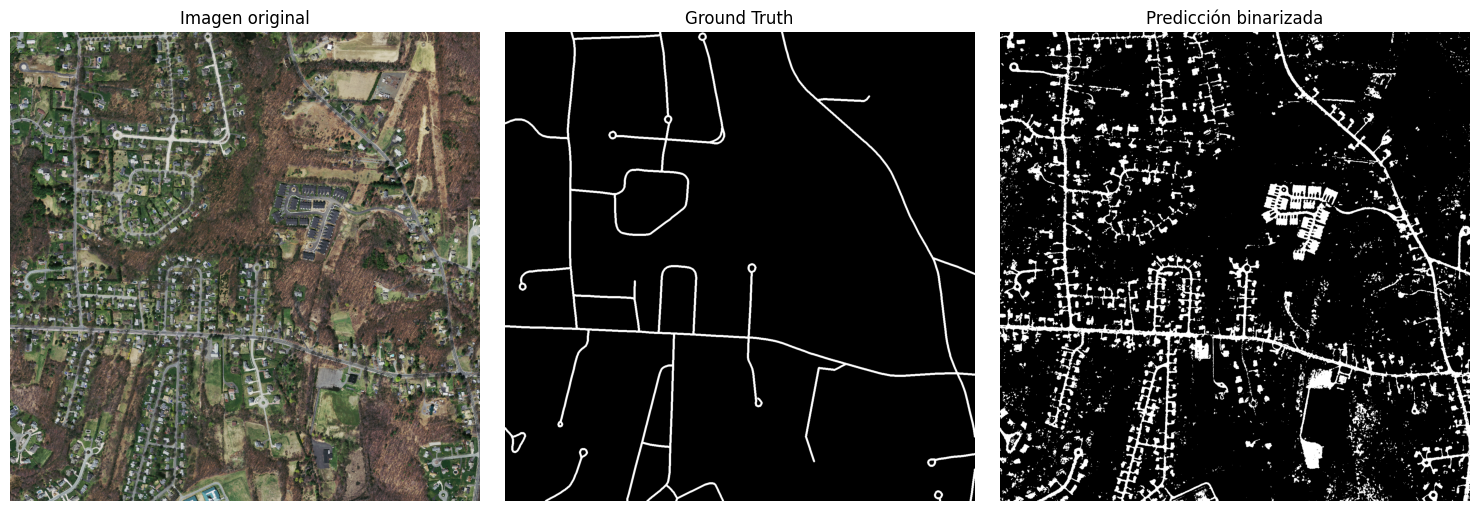
Comparativa da segmentación en imaxe de proba (4)
7. Post-procesado da segmentación obtida
Trataremos de mellorar a segmentación obtida mediante un post-procesado. Para iso, probaremos unha serie de técnicas e elixiremos aquelas que ofrezan un bo resultado.
Finalmente o noso post-procesado componse de:
- Umbral de 0.6 para a binarización da imaxe obtida polo clasificador.
- Eliminación de compoñentes conexos de tamaño menor a 50 píxeles.
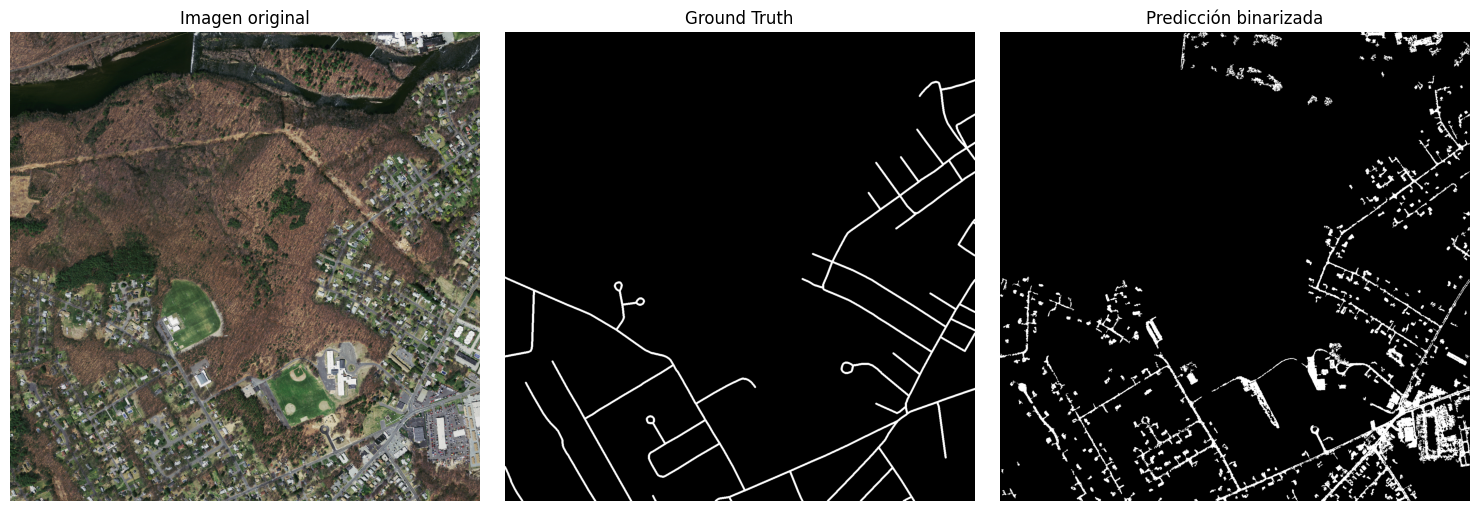
Segmentación final tras o post-procesado (1)
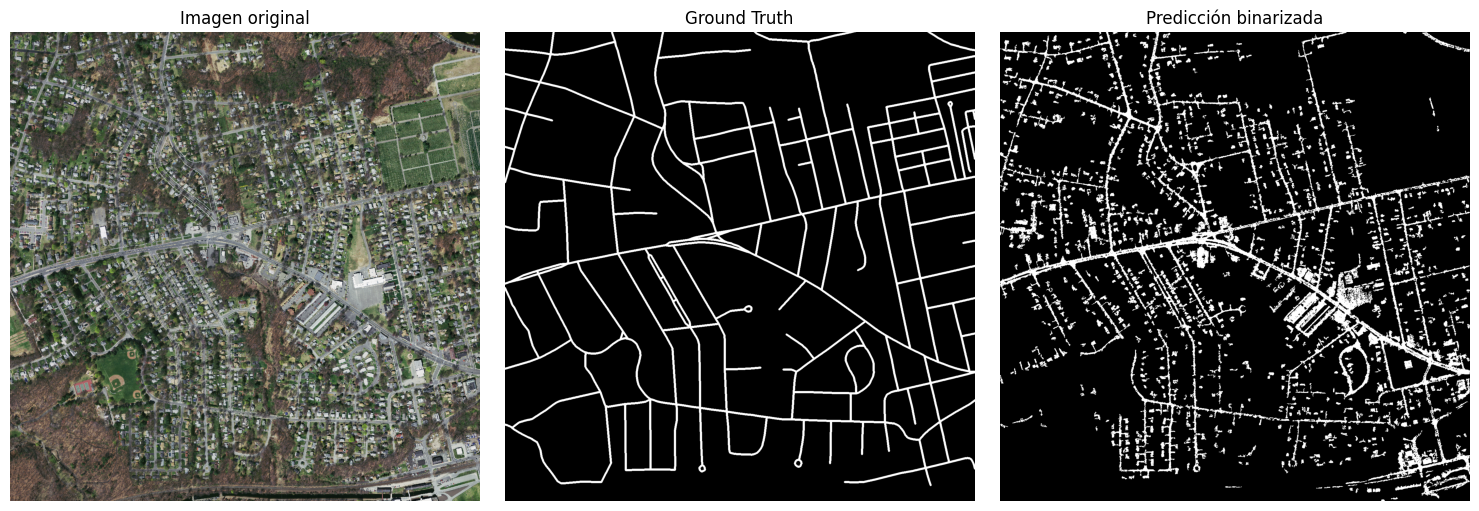
Segmentación final tras o post-procesado (2)
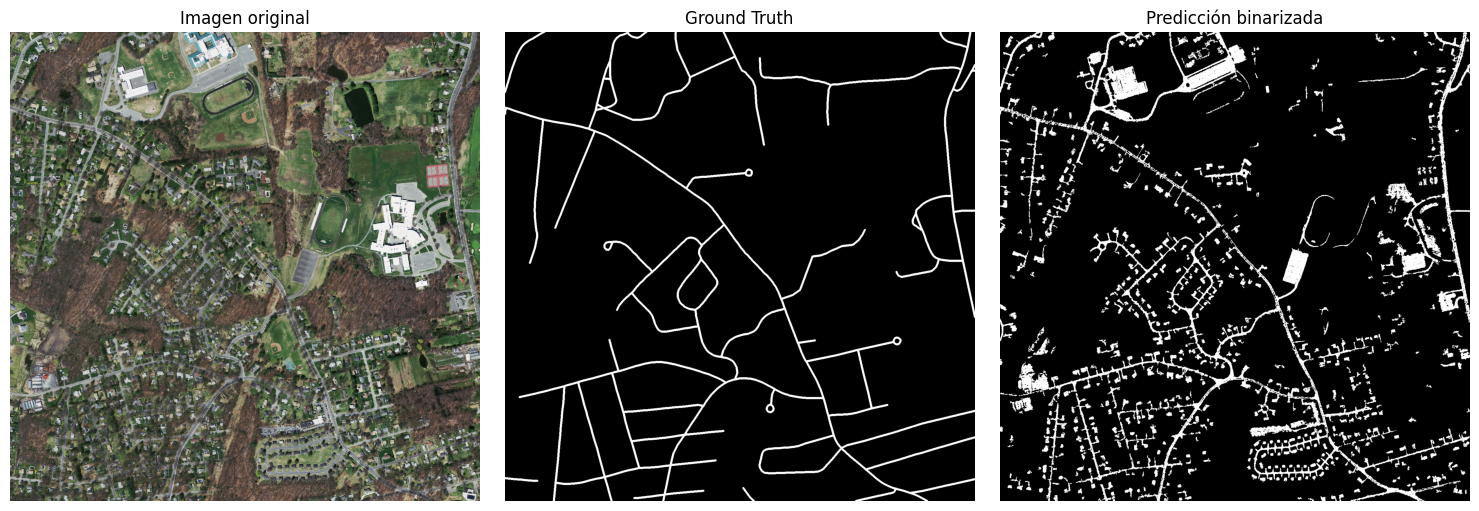
Segmentación final tras o post-procesado (3)
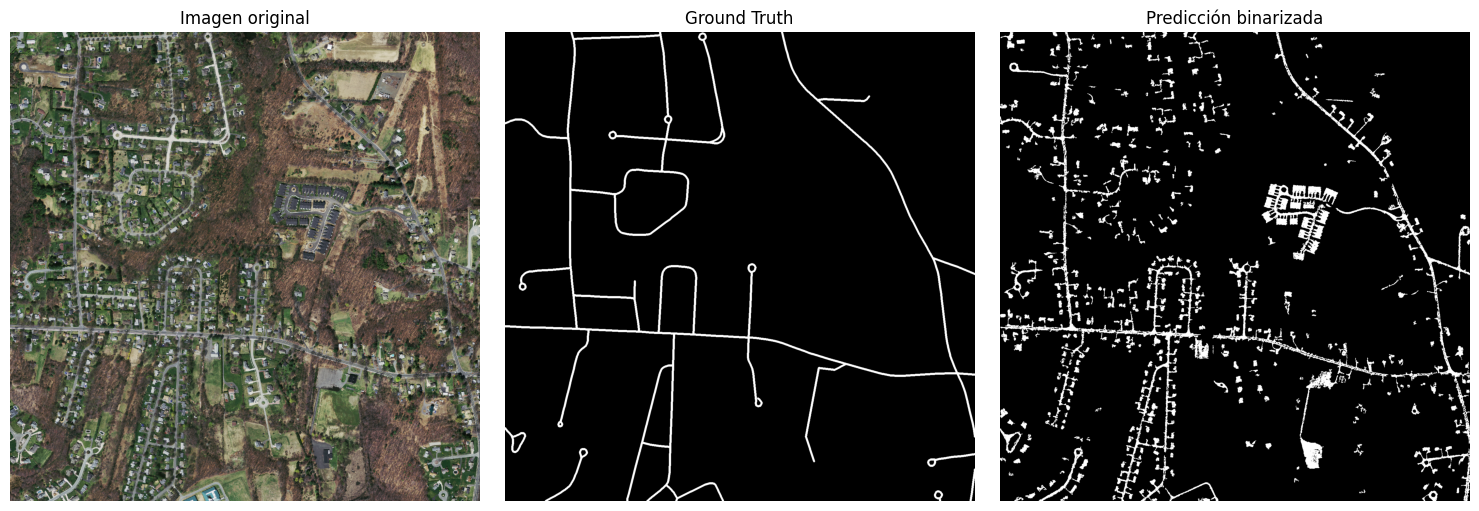
Segmentación final tras o post-procesado (4)
Conclusións finais
Valoración xeral:
Cuantitativamente, a segmentación obtida polo clasificador é bastante boa, cun resultado de AUC de 0.89.
A segmentación obtida polo clasificador non é perfecta pero bastante. Obsérvanse erros de segmentación na imaxe binaria obtida. Estes erros son principalmente píxeles de ruído que se clasificaron como estrada e pequenas discontinuidades pero tamén hai estruturas máis grandes que detecta como estradas.
Puntos débiles do modelo. Erros:
O noso modelo identifica gran cantidade de tellados como estradas, non creamos un modelo capaz de diferenciar entre ambos de forma efectiva. Pasa o mesmo con naves industriais ou grandes superficies.
Existen discontinuidades nas estradas predicidas que non se conseguen eliminar no post-procesado.
A nosa imaxe binaria ten puntos mínimos de ruído que non se logran eliminar co etiquetado de compoñentes conexos.
Hai varias estradas que non se detectan, e que si son estradas no ground truth e máis importante, poden ser identificadas como tal na imaxe de satélite.
Puntos fortes do modelo:
As nosas segmentacións diferencian de forma moi efectiva estradas de camiños forestais ou cortalumes.
Obtéñense estradas non determinadas polo ground truth pero que son efectivamente estradas á vista da imaxe de satélite.
Todas as estradas estreitas entre casas ou pola contra zonas extensas asfaltadas (como parkings) son identificadas como estrada polo noso modelo.
O noso modelo xeneraliza ben, a segmentación é boa nas imaxes que aprendeu pero non sobreadestra a estas e é capaz de predicir as do conxunto de test.
Máis información
Para maior detalle do proxecto pódese consultar o notebook co código completo e os resultados obtidos en cada paso do proceso no repositorio en GitHub do proxecto