Introdución
Como definimos o que fai a dous ciclistas similares? Neste proxecto, analicei datos do pelotón profesional para construír un sistema de recomendación de ciclistas. Utilizando técnicas de limpeza de datos e métricas de distancia vectorial, logrei identificar que corredores comparten perfís de rendemento similares, independentemente do seu equipo ou nacionalidade.
Proceso de Desenvolvemento
O proxecto centrouse en transformar datos tabulares crus en perfís de rendemento comparables.
1. Recolección de Datos
Os datos obtivéronse de fontes públicas, concretamente tras unha procura exhaustiva, decidiuse utilizar os proporcionados en Cycling Oracle
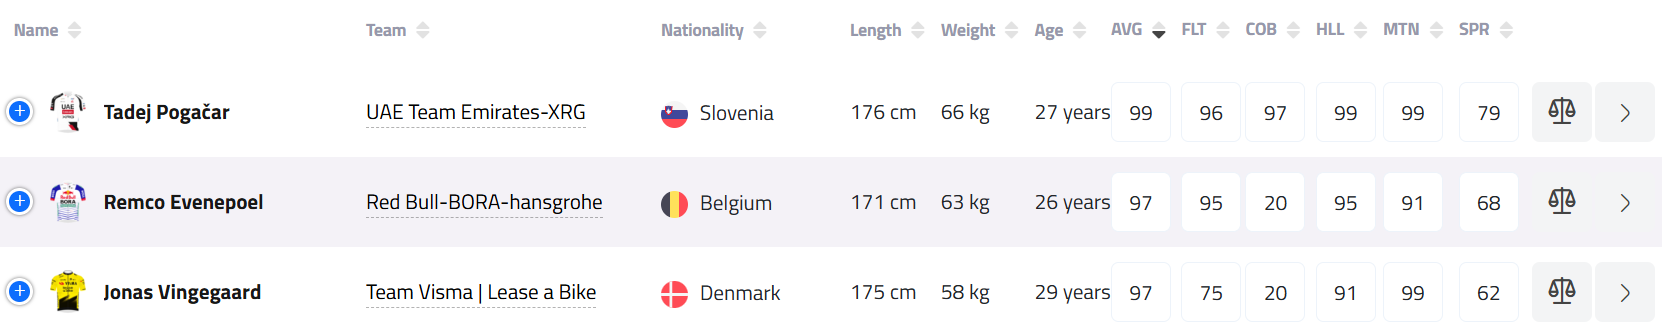
Datos de exemplo procedentes de Cycling Oracle
Estes datos incluían unha puntuación sobre 100 que reflicte o rendemento de cada ciclista en diferentes tipos de carreiras (clásicas, etapas de montaña, contrarreloxo, etc.), así como a súa idade e a súa puntuación media.
2. Limpeza e Normalización
A clave foi normalizar as variables numéricas (como vitorias, puntos UCI, idade ou especialidade) para que ningunha característica dominase sobre as outras.
- Manexo de valores nulos: Aplicáronse técnicas para que os datos faltantes non provocasen erros no cálculo de similitude.
- Feature Engineering: Creación de indicadores de “perfil escalador” fronte a “rodador” mediante a análise dos seus puntos.
3. Medición de Similitude: Motor de Recomendación Multimodal
Para determinar a afinidade entre corredores, implementei un sistema híbrido que combina tres métricas distintas, equilibradas mediante pesos específicos para maximizar a relevancia deportiva:
Similitude Coseno Ponderada (60%): En lugar de tratar todas as habilidades por igual, apliquei pesos dinámicos segundo as fortalezas do ciclista. Se un corredor destaca nunha disciplina (score > 70), o modelo duplica o peso desa característica, evitando que as “debilidades” (disciplinas nas que non compite) distorsionen a recomendación.
Distancia Euclidiana Inversa (25%): Utilizada para medir a proximidade absoluta no espazo vectorial, asegurando que os corredores con niveis de rendemento similares a nivel numérico obteñan unha bonificación.
Similitude Física (15%): Procesei os datos de altura, peso e idade mediante unha imputación robusta de nulos, permitindo que o sistema compare morfoloxías incluso con datos incompletos.
Refinamento Lóxico
Ademais das métricas matemáticas, engadín unha capa de lóxica de filtrado para refinar os resultados:
Penalización por idade: Apliquei un factor de penalización para ciclistas cunha diferenza maior a 7 anos, priorizando cohortes xeracionais comparables.
Bonificación de Perfil: Otorgase un bonus adicional se ambos corredores comparten o mesmo perfil dominante (ex: Escalador vs Escalador), asegurando que o modelo prefira especialistas na mesma disciplina.
# Combinación ponderada de métricas
combined_scores = (0.60 * cosine_scores + 0.25 * euclidean_scores + 0.15 * physical_scores)

# Aplicación de filtros intelixentes (Idade e Perfil)
results['SimilarityScore'] = results['SimilarityScore'] - results['AgePenalty']
results['SimilarityScore'] = results['SimilarityScore'] + results['ProfileBonus']
4. Construción da Web App
Para facer accesible o sistema de recomendación, desenvolvin unha aplicación web utilizando Flask. A interface permite aos usuarios seleccionar un ciclista e visualizar as súas recomendacións de similitude, xunto con gráficos que mostran a comparación de perfís.
Resultado
Máis aló da validación empírica de relacións obvias, o motor actúa como unha ferramenta de scouting analítico. Ao identificar a sinatura de rendemento subxacente nun espazo vectorial multidimensional, o modelo permite detectar talentos emerxentes cuxo perfil estatístico é análogo ao dos líderes do WorldTour, facilitando a prospección de promesas antes da súa consolidación na élite.
A aplicación web está dispoñible para o seu uso, e pódese acceder a ela a través do seguinte enlace: Ciclistas Similares
Buscador
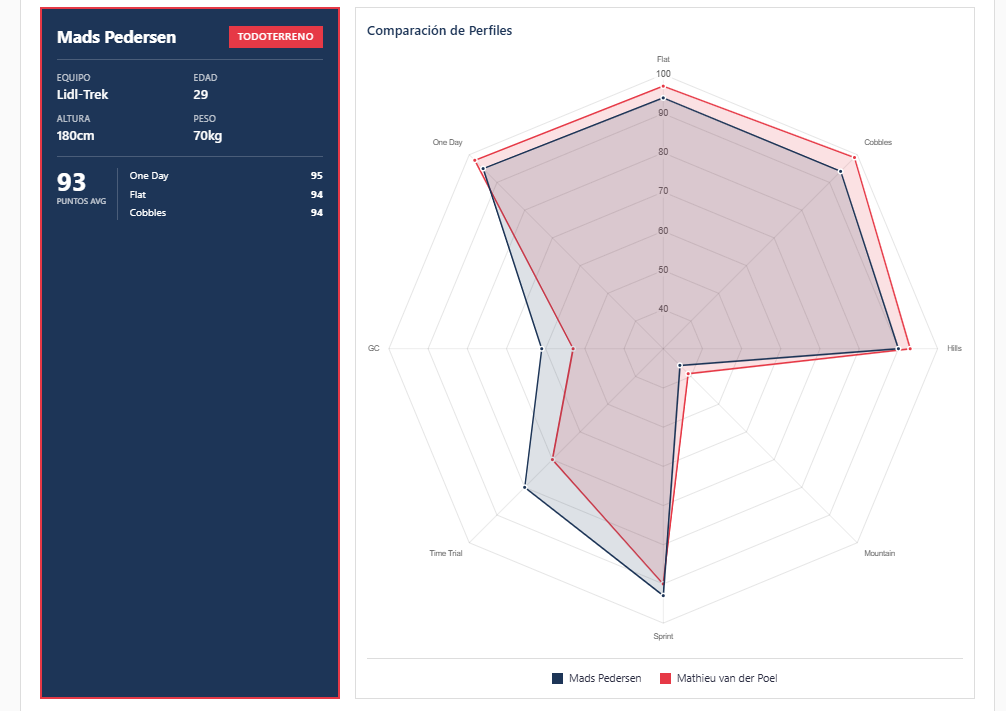
Gráfica comparativa
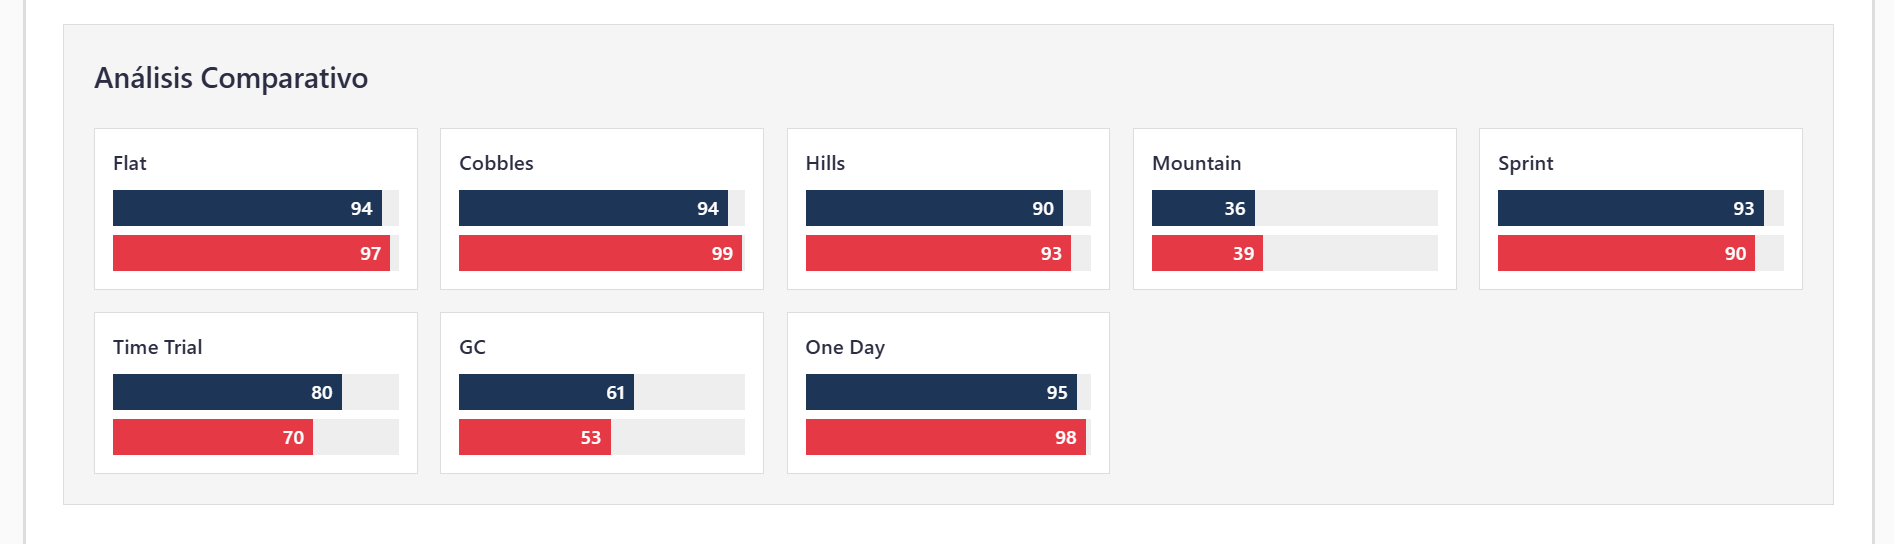
Gráficas de barras comparativas
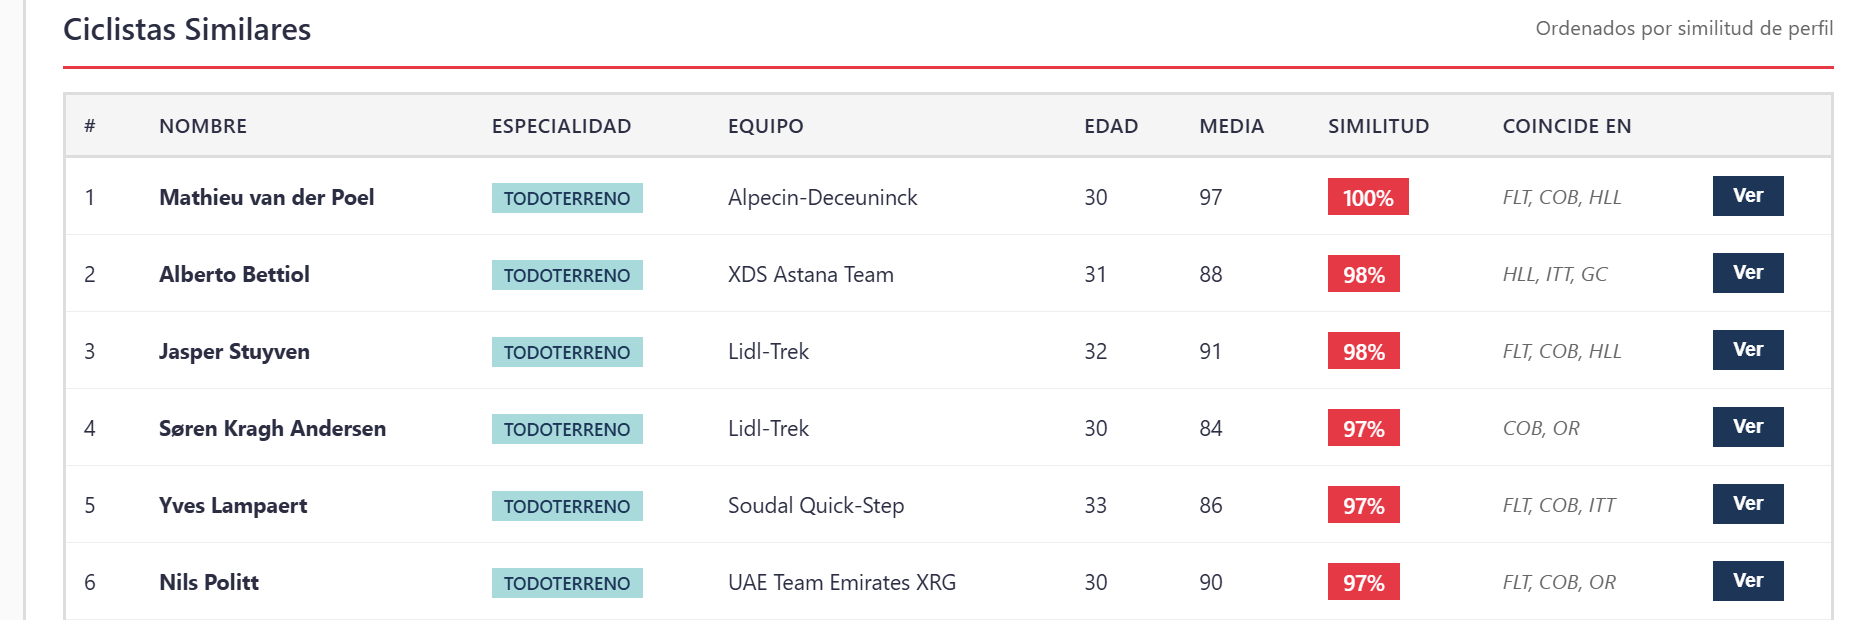
Tabla de ciclistas similares