Objetivo
Desarrollar un método computacional que permita:
Segmentar las carreteras existentes en una imagen de entrada. Es decir, dada una imagen aérea, proporcionar una máscara binaria con los píxeles de carretera a 1 y el resto a 0.
Para un conjunto de imágenes de prueba, proporcionar un conjunto de métricas de evaluación cuantitativa de la segmentación apropiadas para la aplicación objetivo, usando el ground truth correspondiente.
Esquema del trabajo
Cargar las imagenes de entrada y cada ground truth.
Experimentación de posibles operaciones sobre las imagenes originales que nos permitan obtener características relevantes de los puntos.
- Se probaron diferentes filtros y técnicas de procesamiento de imagen para encontrar aquellas que mejor se adapte a la segmentación de carreteras.
Creación de un vector de características por cada píxel de la imagen aérea.
- Los valores obtenidos con las operaciones del paso anterior caracterizarán a cada píxel de la imagen.
División en el conjunto de entrenamiento y de test.
- Se divide el 80% de las imágenes para el entrenamiento y el 20% restante para la evaluación del modelo.
Creación y entrenamiento de un clasificador con los vectores de características y etiquetas obtenidas.
- Se define la arquitectura del clasificador, se prueban diferentes modelos.
Evaluación del clasificador con el conjunto de imágenes de prueba y se obtiene la segmentación de carreteras.
Se obtienen las métricas de evaluación del clasificador con el conjunto de test.
Se predicen las etiquetas de cada píxel de la imagen de entrada y se obtiene la segmentación de carreteras.
Se visualiza la segmentación obtenida y se compara con el ground truth correspondiente.
Las mejores predicciones son sometidas a un post-procesado
1. Cargar la imagen y el ground truth
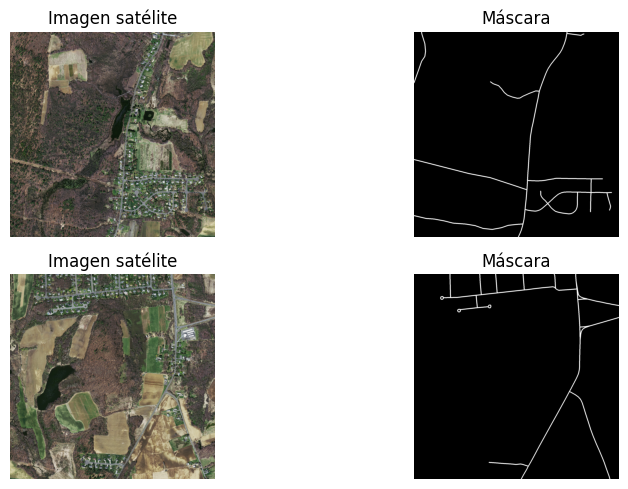
Imagen aérea de entrada y su ground truth
2. Experimentación para la extracción de características
Se experimentó con diferentes filtros y técnicas de procesamiento de imágenes para obtener características relevantes que nos ayuden a segmentar las carreteras.
3. Vector de características
Tras la experimentación con diferentes filtros y técnicas de procesamiento de imágenes, se ha decidido que el vector de características estará formado por los siguientes elementos:
Canales R, G y B de la imagen original para obtener información de color.
Canalles H y S de la imagen en espacio HSV para obtener información de color.
Umbralización manual sobre el canal b (previamente expandido)
Umbralización de Otsu sobre los canales H y S
Dirección y magnitud del gradiente de la imagen en escala de grises.
def caracteristicas(imagen):
    """
    Calcula las características de una imagen de satélite para la detección de carreteras.

    Args:
        imagen (ndarray): Imagen de entrada.

    Returns:
        array: Características de la imagen.
        - Canales R, G y B de la imagen original para obtener información de color.
        - Umbralización manual sobre el canal b (previamente expandido)
        - Umbralización de Otsu sobre el canal H y S
        - Dirección y magnitud del gradiente de la imagen original con un sigma de 1 y discretización a 36 direcciones.
    """

    ## Convertimos la imagen a escala de grises
    imagen_gray = skimage.color.rgb2gray(imagen)

    ## Calculamos el gradiente y la orientación con un sigma de 1 y discretización a 36 direcciones
    grad = magnitud_gradiente(imagen_gray, sigma=1)
    orient = orientacion_gradiente(imagen_gray, sigma=1, angulos_discretos=8)

    ## Convertimos la imagen a HSV
    imagen_hsv = skimage.color.rgb2hsv(imagen)

    ## Obtenemos los canales H y S
    canal_h = imagen_hsv[:, :, 0]
    canal_s = imagen_hsv[:, :, 1]

    ## Calculamos el gradiente y la orientación del canal H
    # grad_h = magnitud_gradiente(canal_h, sigma=1)
    # orient_h = orientacion_gradiente(canal_h, sigma=1, angulos_discretos=8)

    ## Umbralizamos los canales H y S usando Otsu
    umbral_h = skimage.filters.threshold_otsu(canal_h)
    umbral_s = skimage.filters.threshold_otsu(canal_s)

    ## Convertimos la imagen a LAB
    imagen_lab = skimage.color.rgb2lab(imagen)
    # Obtenemos el canal b
    canal_b = imagen_lab[:, :, 2]
    # Normalizamos el canal b al rango [0, 1]
    canal_b = (canal_b + 128) / (127 + 128)
    # Expandimos el histograma del canal b
    canal_b = exposure.rescale_intensity(canal_b, in_range='image', out_range=(0, 1))
    # Umbralizamos el canal b usando un umbral manual
    umbral_b = 0.4

    ## Creamos una lista con las características
    caracteristicas = [imagen[:, :, i] for i in range(3)] + \
                      [canal_h] + \
                      [canal_s] + \
                      [canal_b < umbral_b] + \
                      [canal_h > umbral_h] + \
                      [canal_s > umbral_s] + \
                      [grad, orient]

    ## Reshape de las características para que tengan la misma forma
    caracteristicas = np.array(caracteristicas)
    caracteristicas = np.transpose(caracteristicas, (1, 2, 0))

    return caracteristicas
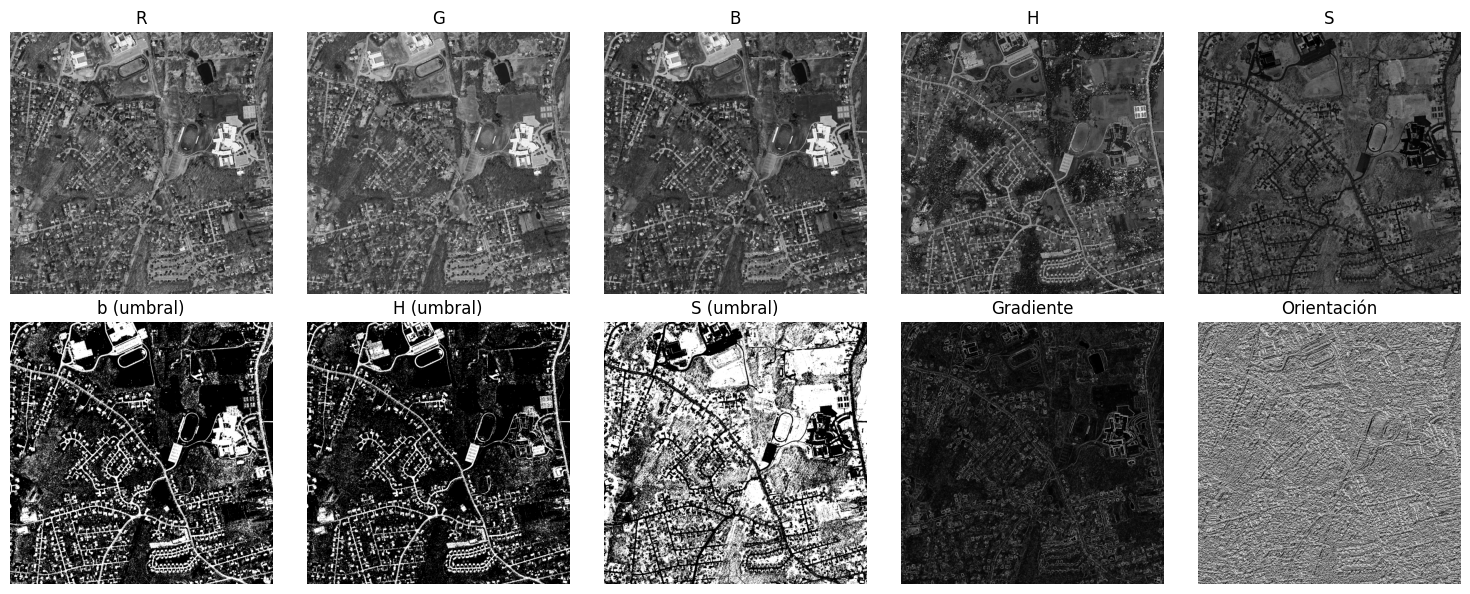
Ejemplo del vector de características construido por el clasificador
4. Creación de los conjuntos de entrenamiento y test
Dividimos las imagenes de satelite en un conjunto de entrenamiento (80%) y un conjunto de test (20%). Hemos prescindido del uso de funciones para la división de los conjuntos de entrenamiento y test, ya que el tamaño de las imágenes es pequeño pero dispar y no es necesario realizar una división aleatoria.
Realmente, si el objetivo solamente es segmentar las carreteras en las imágenes concretas, la división de datos no sería necesaria, sería suficiente con entrenar un modelo con todas las imágenes sin importar que este sobreentrene, es más sería incluso útil un sobreentrenamiento.
En el trabajo decidimos dividir los datos para tratar de entrenar un modelo que pueda generalizar a otras imágenes de carreteras, no solamente a las imágenes concretas que se nos ofrecen.
5. Creación del clasificador
La función siguiente servirá para crear nuestro clasificador binario (carretera / no carretera) haciendo uso de una red convolucional.
def modelo1(input_shape):
    inputs = layers.Input(shape=input_shape)

    x = layers.Conv2D(32, (3, 3), activation='relu', padding='same')(inputs)

    x = layers.Conv2D(16, (3, 3), activation='relu', padding='same')(x)

    x = layers.Conv2D(1, (1, 1), activation='sigmoid', padding='same')(x)

    outputs = layers.Reshape((input_shape[0], input_shape[1]))(x)
    model = models.Model(inputs=inputs, outputs=outputs)

    model.compile(optimizer=optimizers.Adam(learning_rate=0.001),
              loss=losses.BinaryCrossentropy(),
              metrics=[
                  metrics.BinaryAccuracy(name='accuracy'),
                  metrics.Precision(name='precision'),
                  metrics.Recall(name='recall'),
                  metrics.AUC(name='auc')])

    return model
Aclaración:
Nuestra métrica fundamental para evaluar el rendimiento será AUC (Area Under Curve). Nuestro problema es un claro ejemplo de un problema de clasificación binaria en el que las clases están altamente desbalanceadas, la gran mayoría de los píxeles no son carretera.
Por este motivo, la accuracy no es una métrica adecuada ya que puede ser engañosa. Por ejemplo, si el clasificador predice que todos los píxeles son fondo, la accuracy será igualmente alta (habrá acertado en la mayoría de los píxeles) pero no habrá aprendido nada.
Sin embargo la métrica AUC es aquella que nos indica el ratio entre falsos positivos y verdaderos positivos, por lo que es una métrica más adecuada para nuestro problema. Será 1 si la clasificación es perfecta y 0.5 si la clasificación es aleatoria.
Nota:
Hay que tener en cuenta que el uso de la métrica no evita el problema de desbalanceo, simplemente nos ayudará a evaluar el rendimiento del clasificador.
En caso de querer mitigar el problema de desbalanceo, se podrían aplicar técnicas como el oversampling, el uso de pesos dándole más importancia a la clase minoritaria (carretera) o la definición de funciones de pérdida específicas para este problema.
En este caso, aúnque se ha probado a modificar la función de perdida en alguno de los modelos creados (presente en la parte final del Notebook), hemos llegado a un entrenamiento satisfactorio sin esta técnica. De todas formas, debemos ser conscientes del problema existente.
Creamos el clasificador y lo entrenamos con el conjunto de entrenamiento. Este modelo recibe como entrada directamente la matriz de 1500x1500x10, no se realiza un flatten de la imagen. Cada una de las imágenes constituye un batch.
## Creamos el modelo
INPUT_SHAPE = (1500, 1500, 10)
model = modelo1(input_shape=INPUT_SHAPE)

## Resumen del modelo
model.summary()

## Entrenamos el modelo
history = model.fit(x_train, y_train, epochs=5, batch_size=1)

## Guardamos el modelo
model.save("modelo1.keras")
Conclusión
Creamos una red convolucional con dos capas de 32 y 16 neuronas respectivamente y activación relu y otra capa de 1 neurona y activación sigmoid. Se ha probado a definir una arquitectura más compleja pero el aumento de la complejidad no ofrecía mejoras significativas y aumentaba considerablemente el coste computacional, resultando practicamente imposible el entrenamiento. Se ha utilizado la función de pérdida
binary_crossentropyy el optimizador Adam. El entrenamiento se ha realizado durante 5 épocas. La métrica utilizada para evaluar el rendimiento del clasificador es AUC (Area Under Curve).La salida de la red es un valor entre 0 y 1 que indica la probabilidad de que el píxel sea carretera, más adelante se tratará con esto para obtener la segmentación binaria.
6. Evaluación del clasificador en el conjunto de imágenes de prueba
Cargamos el clasificador model.keras y lo evaluamos con el conjunto de test. Obtenemos las métricas de evaluación.
Conclusión:
Obtenemos un AUC de 0.89, lo que indica que el clasificador tiene un buen rendimiento. Se evaluará de forma cualitativa la segmentación obtenida en las imágenes de prueba.
Definimos una función para visualizar los resultados. Se mostrará la imagen de satélite, el ground truth y la segmentación obtenida por el clasificador. Cabe destacar que la salida de nuestro modelo, y por tanto de la predicción es una probabilidad entre 0 y 1 para cada píxel, por lo que se aplicará un umbral para convertir la salida a una imagen binaria.
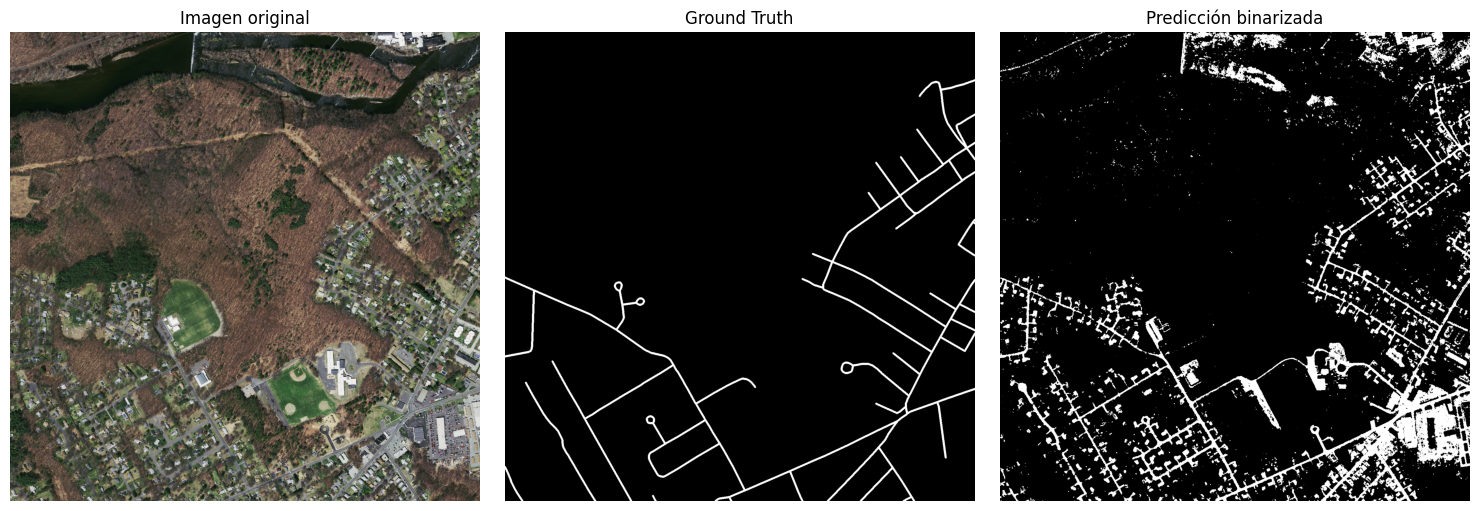
Comparativa de la segmentación en imagen de prueba (1)
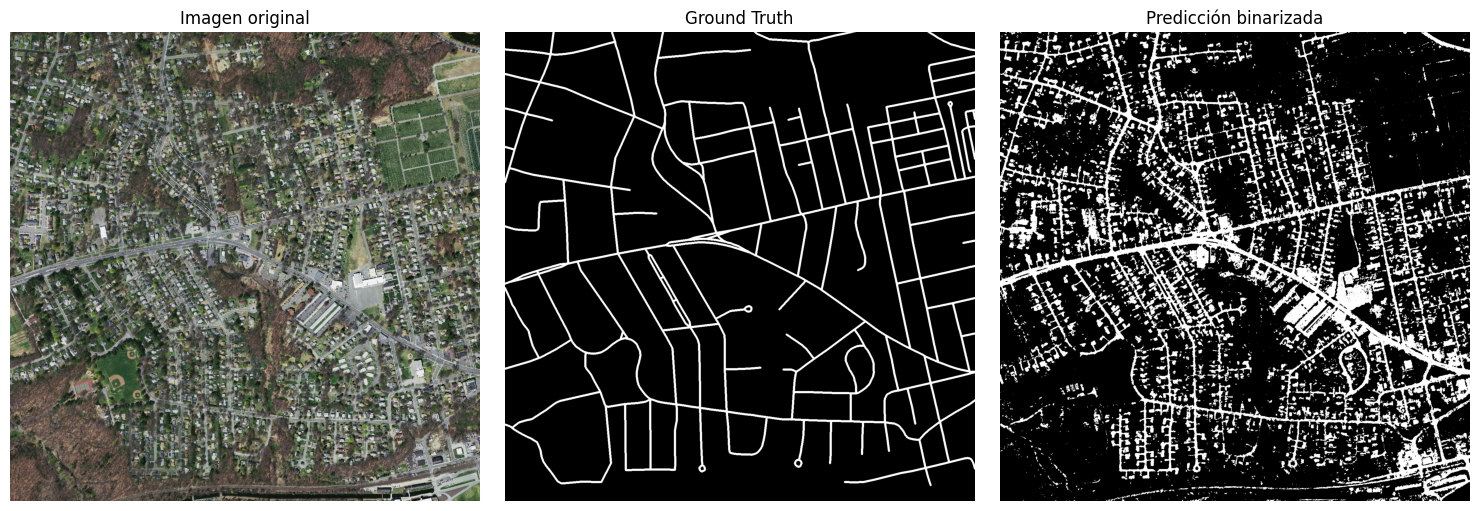
Comparativa de la segmentación en imagen de prueba (2)
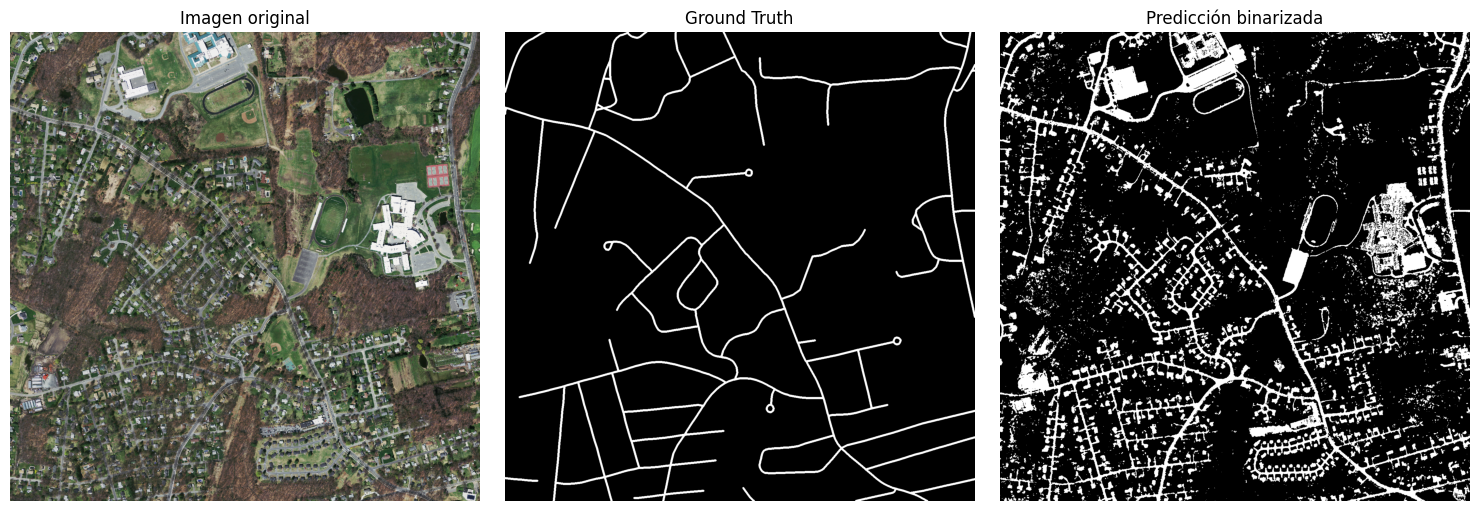
Comparativa de la segmentación en imagen de prueba (3)
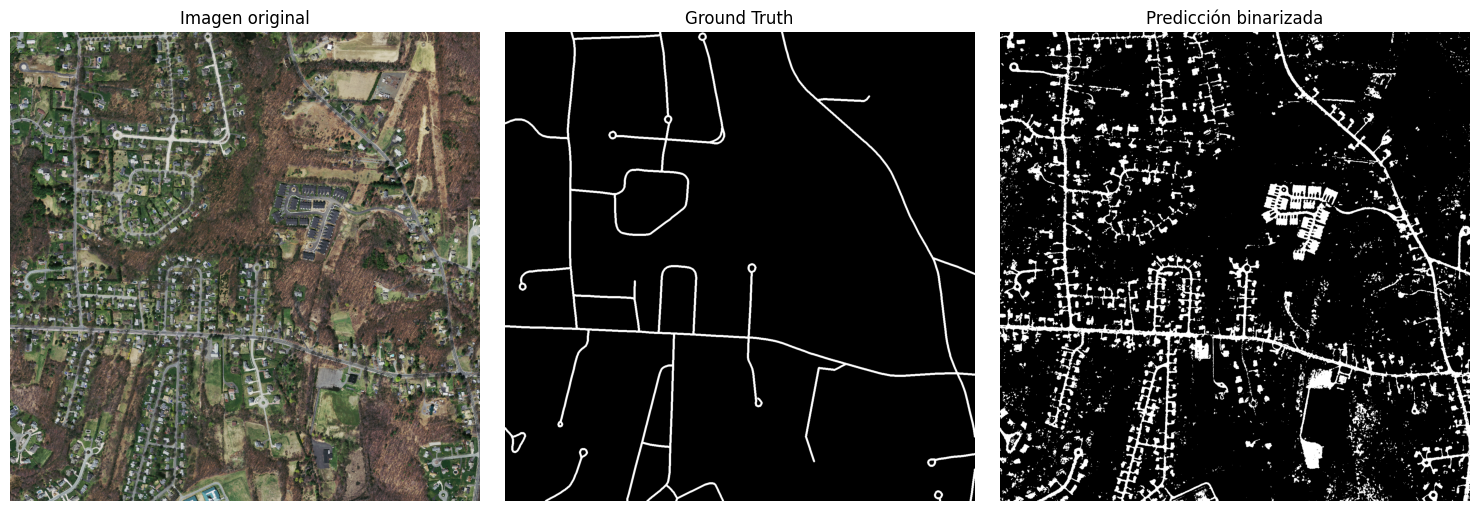
Comparativa de la segmentación en imagen de prueba (4)
7. Post-procesado de la segmentación obtenida
Trataremos de mejorar la segmentación obtenida mediante un post-procesado. Para ello, probaremos una serie de técnicas y elegiremos aquellas que ofrezcan un buen resultado.
Finalmente nuestro post-procesado se compone de:
- Umbral de 0.6 para la binarización de la imagen obtenida por el clasificador.
- Eliminación de componentes conexos de tamaño menor a 50 píxeles.
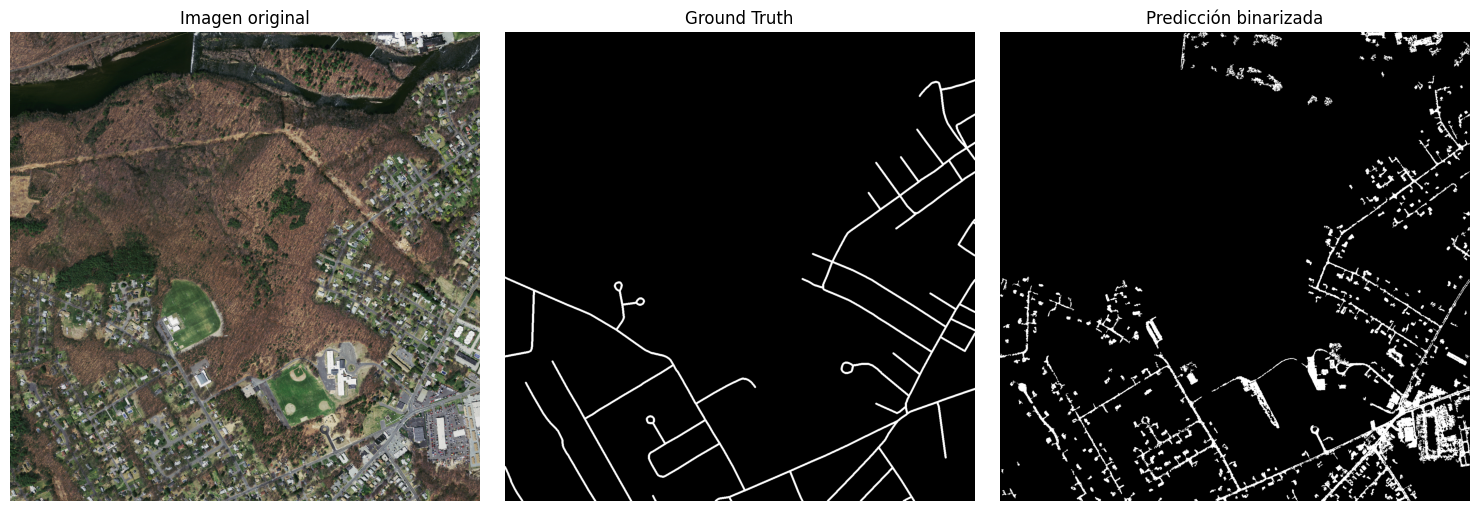
Segmentación final tras el post-procesado (1)
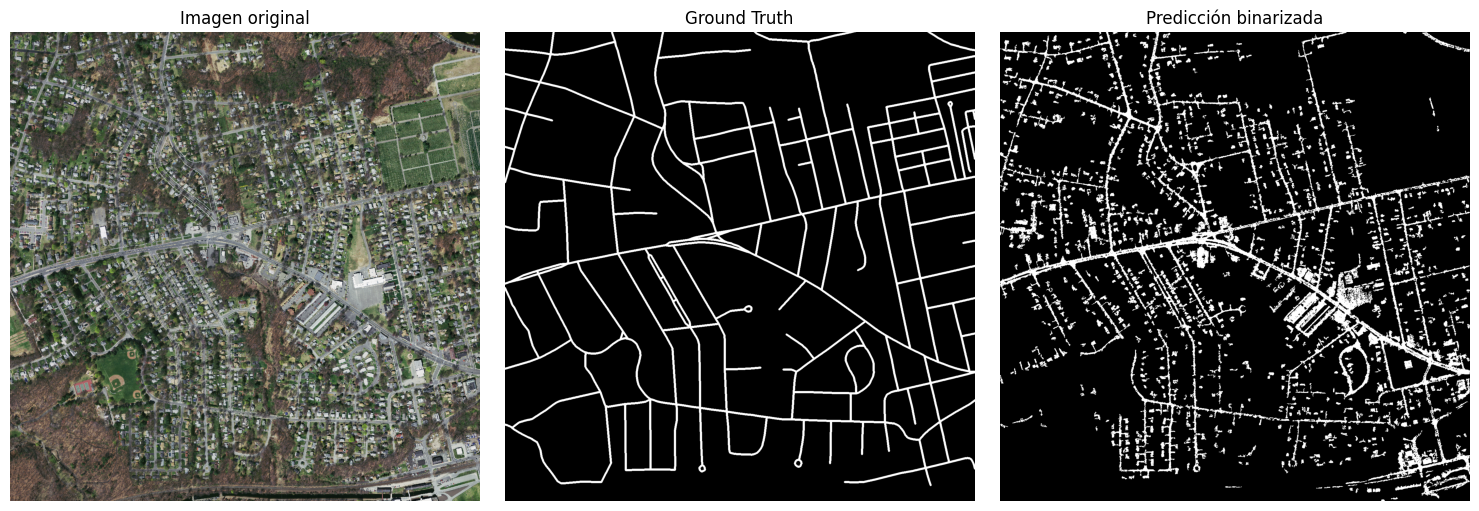
Segmentación final tras el post-procesado (2)
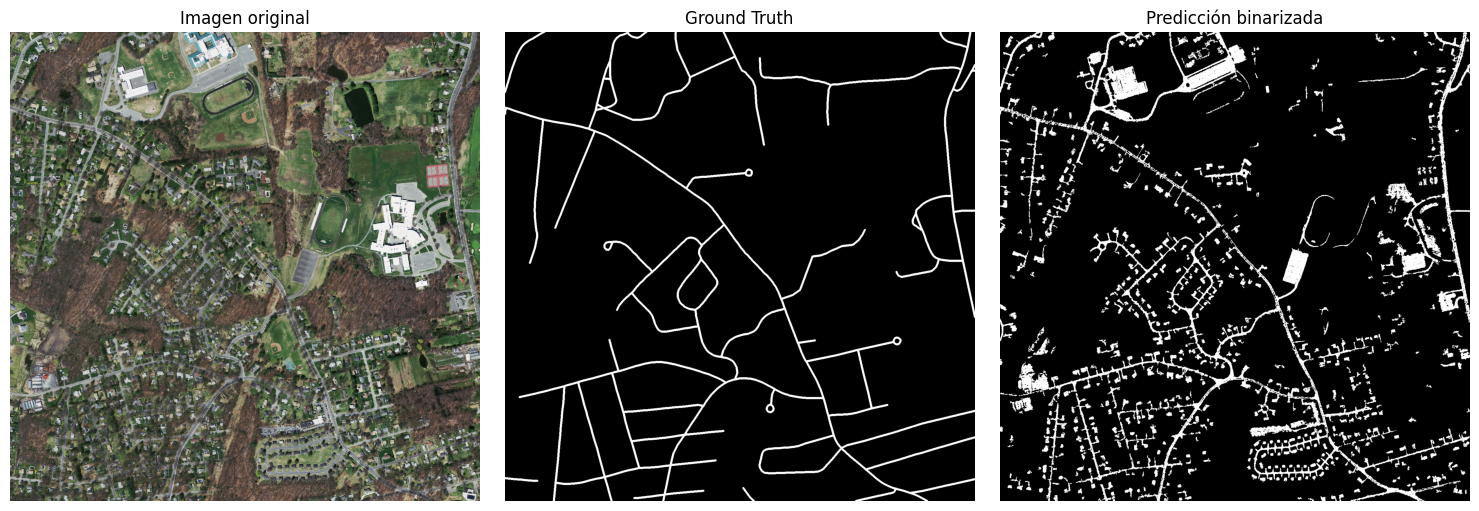
Segmentación final tras el post-procesado (3)
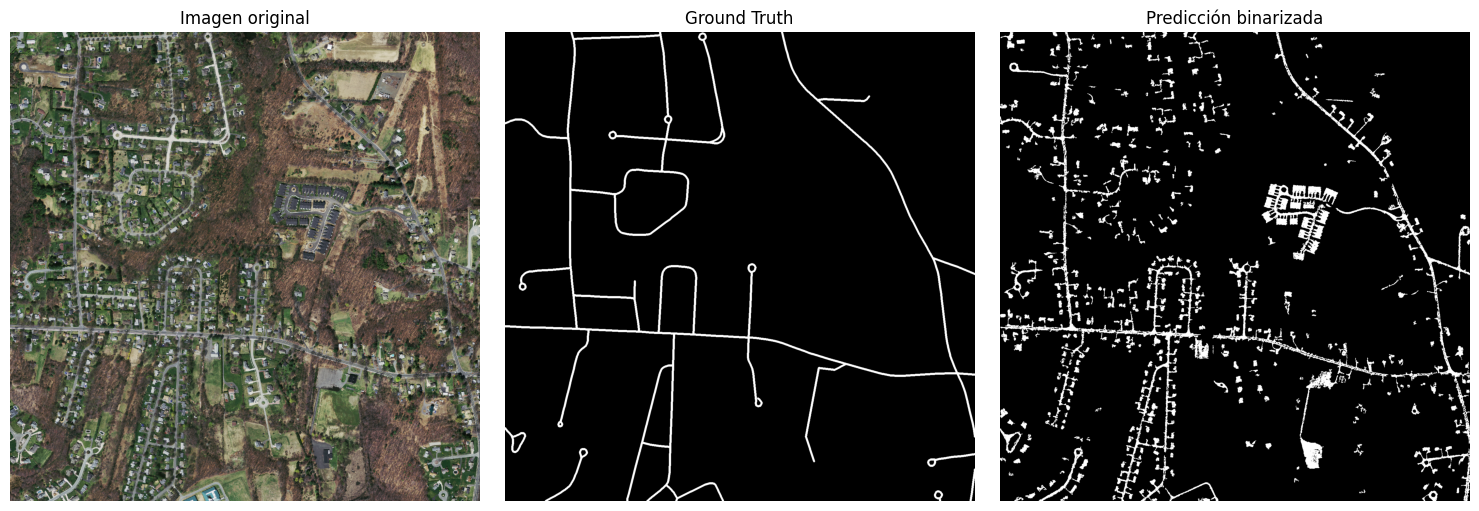
Segmentación final tras el post-procesado (4)
Conclusiones finales
Valoración general:
Cuantitativamente, la segmentación obtenida por el clasificador es bastante buena, con un resultado de AUC de 0.89.
La segmentación obtenida por el clasificador no es perfecta pero bastante. Se observan errores de segmentación en la imagen binaria obtenida. Estos errores son principalmente píxeles de ruido que se han clasificado como carretera y pequeñas discontinuidades pero tambien hay estructuras más grandes que detecta como carreteras.
Puntos débiles del modelo. Errores:
Nuestro modelo identifica gran cantidad de tejados como carreteras, no creamos un modelo capaz de diferenciar entre ambos de forma efectiva. Pasa lo mismo con naves industriales o grandes superficies.
Existen discontinuidades en las carreteras predichas que no se consiguen eliminar en el post-procesado.
Nuestra imagen binaria tiene puntos mínimos de ruido que no se logran eliminar con el etiquetado de componentes conexos.
Hay varias carreteras que no se detectan, y que sí son carreteras en el groud truth y más importante, pueden ser identificadas como tal en la imagen de satélite.
Puntos fuertes del modelo:
Nuestras segmentaciones diferencian de forma muy efectiva carreteras de caminos forestales o cortafuegos.
Se obtienen carreteras no determinadas por el ground truth pero que son efectivamente carreteras a la vista de la imagen de satélite.
Todas las carrreteras estrechas entre casas o por el contrario zonas extensas asfaltadas (como parkings) son identificads como carretera por nuestro modelo.
Nuestro modelo generaliza bien, la segmentación es buena en las imágenes que ha aprendido pero no sobreentrena a estas y es capaz de predecir las del conjunto de test.
Más información
Para mayor detalle del proyecto se puede consultar el notebook con el código completo y los resultados obtenidos en cada paso del proceso en el repositorio en GitHub del proyecto